
生成AIの知財ルール、プリンシプルコードについて解説します
近年、ChatGPT Claude Geminiといった生成AIによって、研究開発、創作活動や、事業活動の生産性と創造性が飛躍的に高まっています。その一方で、生成AIによる生成物と著作権・特許権等の知的財産権との関係で、権利侵害の可能性という課題が生じています。
そこで、2026年8月25日、内閣官房の知的財産戦略本部は、生成AI技術の進歩の促進と知的財産権の適切な保護との両立に向け、権利者や利用者にとって安全・安心な利用環境を確保するためのルールとして、プリンシプルコードを発表しました。
今回は、このプリンシプルコードについて解説します。
プリンシプルコードとは何か
プリンシプルコードとは、生成AI開発者や生成AI提供者(これらを総称して、生成AI事業者と言います)に、知的財産権保護と学習データの透明性確保を求める原則です。したがって、この原則を求められる対象者は、生成AI開発者や生成AI提供者などの生成AI事業者です。
その一方で、プリンシプル・コードは、法律のように直接的な法的拘束力を有するものではなく、生成AI事業者に対し、知的財産権の保護及び透明性確保のための原則を示すソフトローです。生成AI事業者には、原則を実施するか、実施しない場合にはその理由を外部に説明する「コンプライ・オア・エクスプレイン」の対応が求められています。このようにした理由としては、法律の制定や改正が生成AIの開発速度に追い付かない可能性がある、ということが挙げられます。
用語の説明
今回の記事では、日常であまり聞かない用語が複数出てきます。そこで、今回の記事で出てくる用語について、以下に説明します。
【生成AI】:文章、画像、プログラム等を生成できるAIモデルに基づくAIの総称。
【生成AI開発者】:生成AIシステムを開発し、当該システムを公衆に提供する事業者。
【生成AI提供者】: 開発された生成AIシステムをアプリケーション等に組み込み、生成AIサービスとして公衆に提供する事業者。
【アカウンタビリティ】:利害関係者に対し、自社の行動や結果について詳しく説明する責任(説明責任)
【ウェブクロール】:ウェブサイトを自動的に巡回し、ページ内のテキスト、画像、リンクなどの情報を取得するプロセス
【トレーサビリティ】:製品やサービスの履歴、所在、用途などを追跡できる状態(追跡可能性)
【ペイウォール】:ウェブマガジン等のデジタルメディア上でアクセスに制限を設け、会員登録したユーザーや料金を支払ったユーザーのみがコンテンツを利用できる仕組み
【C2PA】:画像・動画・音声・文書などのデジタルコンテンツに「誰が・いつ・どのように作成・編集したか」という来歴情報を暗号署名付きで埋め込み、改ざん検知と出所証明を可能にする国際標準規格。
プリンシプルコードの3原則
プリンシプルコードでは、成AI技術の進歩の促進と知的財産権の適切な保護との両立という観点から、3つの原則を定めています。プリンシプルコードの3原則は、次の①から③です。
① 透明性の確保
② 権利者からの開示請求への対応
③ 利用者からの開示請求への対応
これらの3原則のうち、①透明性の確保は、生成AI事業者が能動的に情報を公表するものです。また、②及び③の対応は、照会に対し回答するものです。
透明性確保のための開示
透明性確保の原則では、生成AI事業者に対し、自らの管理又は運用するウェブサイト(生成AI事業者の概要、事業内容、製品情報等の公式情報を発信するウェブサイトであって、全ての者が閲覧可能なもの)において、以下に定める各事項の概要を公開することが求められています。
① 透明性確保のための措置として公開を求められている事項としては、以下の3つが挙げられています。
・使用モデル関係
・学習データ関係
・アカウンタビリティ関係
ただし、これらの事項のうち、営業秘密や安全性・セキュリティの確保に支障を及ぼすおそれのある事項については、開示の対象外となる場合があります。この場合には、後述するコンプライ・オア・エクスプレインに沿った対応が必要です。
そして、これらの事項のうち、使用モデル関係における具体的な事項としては、以下の事項が挙げられています。
・名称(識別子、バージョン等)
・公開日を含む来歴(過去のバージョンや修正履歴等)
・アーキテクチャ・設計仕様
・利用規定(想定する用途や、制限・禁止されている用途の明確化等)
・モデルのトレーニングプロセスの内容(トレーニングの方法等)
また、学習データ関係における具体的な事項としては、以下の事項が挙げられています。
・学習及び検証等に用いられたデータに関連する事項
・クローラ(目的、データ収集期間、名称・識別子、等)
また、アカウンタビリティ関係における具体的な事項としては、以下の事項が挙げられています。
・生成AIシステム又は生成AIサービスの開発・提供・利用中に行われた意思決定等 について、技術的に可能かつ合理的な範囲で追跡・遡及が可能な状態の内容
② 知的財産権保護のための措置としては、以下の対応状況の開示が求められています。
・知的財産権保護のための原則の策定、責任体制の明確化、これらについての年1回以上の見直しとその要旨の公表
・ペイウォール等のアクセス制限やrobots.txt等の機械可読な指示に従うクローラの採用等
・学習したログを一定期間保持する
・いわゆる海賊版サイト等へのクロール回避
・知的財産権を侵害する生成物の生成を防止する技術的措置
・電子透かし、C2PAその他のコンテンツの出所及び来歴を証明するような技術的措置
権利者からの開示請求への対応
権利者からの開示請求への対応では、著作権者等の権利者が法的手続(権利行使・調停・許諾交渉等)の準備・実施に際して、以下の情報の開示を求められた場合には、求めに応じた回答をすることが求められます。
ただし、これらの事項についても、営業秘密や安全性・セキュリティの確保に支障を及ぼすおそれのある事項については、開示の対象外となる場合があります。この場合には、後述するコンプライ・オア・エクスプレインに沿った対応が必要です。
・学習及び検証等に用いられたデータに、自らが照会を行うURL等の情報が含まれているか否か
・開示の求めを受けた者が生成AI提供者である場合において、当該生成AI提供者において回答できないときは、生成AIサービスに搭載された生成AIモデルを開発した者の名称
利用者からの開示請求への対応
利用者からの開示請求への対応では、開示を求める理由、回答の利用目的、及び生成物の生成時に用いたプロンプトが示されていて、法的手続での利用を目的としない場合など、プリンシプルコードに定める要件を満たすときに、所定の情報について回答をすることが求められます。ただし、営業秘密や安全性・セキュリティの確保に支障を及ぼすおそれのある事項については、開示の対象外となる場合があります。
・学習及び検証等に用いられたデータに、開示要求者の生成に係る生成物と同 一又は類似するコンテンツが掲載されたURL等の情報が含まれているか否か
・開示の求めを受けた者が生成AI提供者である場合において、当該生成AI提供者において回答できないときは、生成AIサービスに搭載された生成AIモデルを開発した者の名称
コンプライ・オア・エクスプレインとは
「コンプライ・オア・エクスプレイン」とは、プリンシプル・コードに定められた上記の事項を開示・回答(開示等)するか、開示等しない場合には、その理由を説明するよう求めることを意味しています。ただし、単に非開示の理由を説明すれば足りるというものではなく、開示対象事項の性質や非開示の理由を具体的に説明し、透明性及び知的財産権保護の趣旨に沿って対応することが重要です。この点については、知的財産戦略本部から、具体例が示されていますので、以下に紹介します。
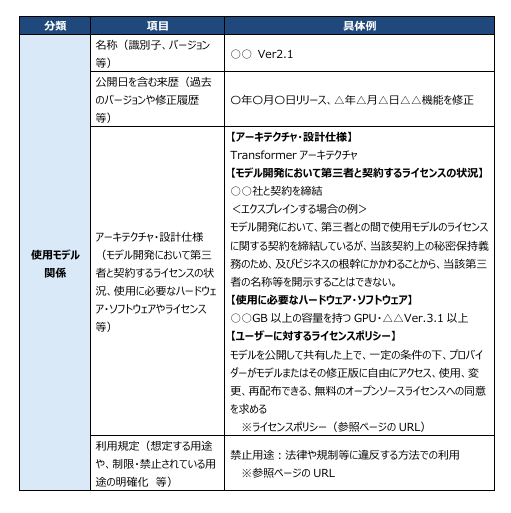
「生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード 概要開示対象事項 具体例(日本語版)」(PDF/601KB)より引用
※内閣官房 知的財産戦略本部のページが参考になります。
AI時代の生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コードの策定及び届出
実務上の注意点
プリンシプルコードにおける実務上の注意点は、生成AIによる生成物が知的財産権を侵害するおそれがあるか否か、という点になります。この知的財産権の侵害については、生成AIの利用者側、提供者側のいずれにも生じる可能性があります。その一方で、実務上の注意点としては、生成AIの利用者側と提供者側とで異なります。
生成AI利用者側の注意点
生成AI利用者側に注意点としては、まず、生成AIによる生成物が知的財産権、特に著作権を侵害していないか確認することが重要です。この著作権侵害の判断においては、生成物と既存の著作物との類似性・依拠性が問題となります。
生成AIの学習データに既存著作物が含まれている場合、その著作物に依拠した生成物が作成される可能性があります。ただし、学習データの取得や利用が違法であったかどうかと、生成物について著作権侵害が成立するかどうかは、区別して判断する必要があります。
プリンシプル・コードに基づく学習データに関する情報の開示は、利用者が生成物の権利侵害リスクを把握するための一助となりますが、開示情報だけで侵害の有無が確定するわけではない点に注意する必要があります。
生成AI提供者側の注意点
生成AI提供者側では、生成AIの開発・学習段階と、生成・提供段階とを区別して、知的財産権侵害のリスクを検討する必要があります。
まず、学習段階では、学習データの取得元、利用許諾の有無及び利用目的等を確認し、著作権法30条の4などの適用可能性を検討することが重要です。学習データに著作物が含まれている場合であっても、必ずしも著作権侵害が成立するわけではなく、利用目的や利用態様等に応じた判断が必要となります。
次に、生成・提供段階では、生成AIが既存著作物に類似するコンテンツを生成するリスクを把握し、必要に応じて侵害防止のための技術的措置を講じることが重要です。また、権利者からの開示請求や利用者からの照会に対し、プリンシプルコードに定める要件及び対象事項に従って適切に対応する必要があります。
さらに、学習データの種類、取得方法、知的財産権保護のための措置等について、コードに従い、透明性を確保することが求められます。営業秘密や安全性・セキュリティに関する情報を非開示とする場合には、その理由を適切に説明することが重要です。
【編集部補足】:一般企業にとって
・ChatGPTやClaude、Geminiなど既存の生成AIサービスを社内業務で利用するだけの一般企業は、通常、プリンシプル・コードの直接の対象となる「生成AI開発者」「生成AI提供者」には該当しません。
・一般企業にとっては、生成AIサービスを選ぶ際に、学習データや知財保護への対応方針を確認することが、サービス選定の判断材料になります。
・外部の生成AIをAPI等で組み込み、自社の生成AIサービスとして広く顧客向けに提供する場合には、「生成AI提供者」に該当する可能性があります。

特許事務所に勤務している弁理士です。中小企業のクライアントを多く扱っています。特許業務が主ですが、意匠・商標も扱います。
あなたの技術に強い弁理士をご紹介!
